Domain forum-cubieboard.de kaufen?
Wir ziehen mit dem Projekt
forum-cubieboard.de um.
Sind Sie am Kauf der Domain
forum-cubieboard.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain forum-cubieboard.de kaufen?
Wie beeinflusst künstliche Intelligenz den Bereich der Informatik? Welche Rolle spielen Big Data und Data Mining in der Informatik?
Künstliche Intelligenz optimiert Prozesse in der Informatik, automatisiert Aufgaben und ermöglicht neue Anwendungen wie maschinelles Lernen. Big Data und Data Mining sind wichtige Werkzeuge in der Informatik, um große Datenmengen zu analysieren, Muster zu erkennen und fundierte Entscheidungen zu treffen. Sie spielen eine zentrale Rolle bei der Entwicklung von KI-Systemen und der Optimierung von Algorithmen. **
Wie funktioniert Big Data?
Wie funktioniert Big Data? **

Ähnliche Suchbegriffe für Mining-Big-Data-Integration
Top-Angebote
Produkte zum Begriff Mining-Big-Data-Integration:
-
Pattern Recognition and Data Mining, Fachbücher von Maneesha Singh, Chid Apte et alDas Fachbuch "Pattern Recognition and Data Mining" von Maneesha Singh und Chid Apte bietet eine umfassende Einführung in die Techniken und Methoden der Mustererkennung und des Data Minings. Mit einem klar strukturierten Ansatz werden grundlegende Konzepte sowie fortgeschrittene Techniken behandelt, die für Studierende und Fachleute im Bereich Technik und IT von Bedeutung sind. Das Buch umfasst 694 Seiten und ist in englischer Sprache verfasst. Es richtet sich an Leser, die ein vertieftes Verständnis für die Analyse von Daten und die Erkennung von Mustern entwickeln möchten. Die erste Auflage, veröffentlicht im Jahr 2005, bietet sowohl theoretische Grundlagen als auch praktische Anwendungen, die in der heutigen datengetriebenen Welt von grosser Relevanz sind. Die kompakte Grösse von 15,5 cm in der Breite und 23,5 cm in der Höhe macht das Buch zudem handlich und leicht transportierbar.94,10 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Data Integration in the Life Sciences, Fachbücher von Erhard RahmDas Fachbuch "Data Integration in the Life Sciences" von Erhard Rahm bietet eine umfassende Analyse der Techniken und Methoden zur Datenintegration in den Lebenswissenschaften. Es behandelt die Herausforderungen und Lösungen, die sich aus der Integration von Daten aus verschiedenen Quellen ergeben, und beleuchtet die Bedeutung dieser Prozesse für die Forschung und Entwicklung in den Lebenswissenschaften. Mit einem klaren Fokus auf Technik und IT bietet das Buch wertvolle Einblicke in die aktuellen Trends und Technologien, die zur Verbesserung der Datenverfügbarkeit und -nutzung beitragen. Die 226 Seiten umfassende Publikation ist in englischer Sprache verfasst und richtet sich an Fachleute, Studierende und Forschende, die sich mit der Datenintegration in ihrem Arbeitsfeld auseinandersetzen. Die erste Auflage, erschienen im Jahr 2004, bleibt ein relevantes Werk für alle, die die Komplexität der Datenintegration verstehen und anwenden möchten.49,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Kaspersky Threat Data Feeds - Open Source ThreatsKaspersky Threat Data Feeds – Open Source Threats In einer Zeit, in der Cyberbedrohungen komplexer und zielgerichteter denn je sind, ist eine umfassende Bedrohungsüberwachung unerlässlich. **Kaspersky Threat Data Feeds - Open Source Threats** stellt eine innovative Lösung dar, die Sicherheitsverantwortlichen aktuelle und relevante Informationen zu Bedrohungen bietet, die aus Open-Source-Quellen stammen. Diese Bedrohungsfeeds ermöglichen es Unternehmen, sich kontinuierlich über die neuesten Bedrohungen aus dem Open-Source-Bereich zu informieren und ihre Sicherheitsmaßnahmen entsprechend anzupassen. Mit Kaspersky Threat Data Feeds - Open Source Threats können Unternehmen proaktiv auf Bedrohungen reagieren und so ihre Widerstandsfähigkeit gegenüber Cyberangriffen deutlich verbessern. Überblick über Kaspersky Threat Data Feeds - Open Source Threats Die Lösung **Kaspersky Threat Data Feeds - Open Source Threats** bietet Unternehmen Zugang zu einer Fülle an Bedrohungsdaten, die speziell aus Open-Source-Quellen gesammelt werden. Diese Feeds bieten detaillierte Informationen über aktuelle Bedrohungen und ermöglichen eine proaktive Abwehr. Durch die kontinuierliche Analyse und Filterung relevanter Daten aus öffentlich zugänglichen Quellen hilft Kaspersky Unternehmen dabei, potenzielle Gefahren frühzeitig zu erkennen und geeignete Schutzmaßnahmen zu implementieren. Hauptfunktionen Echtzeit-Updates zu Open-Source-Bedrohungen: Regelmäßige Aktualisierungen, die es Unternehmen ermöglichen, stets über die neuesten Bedrohungen informiert zu sein. Umfassende Bedrohungsanalyse: Detaillierte Informationen zu Bedrohungen, die aus Open-Source-Quellen stammen und für die Cybersicherheit von Bedeutung sind. Integration in bestehende Sicherheitslösungen: Kaspersky Threat Data Feeds lassen sich problemlos in vorhandene Sicherheitssysteme integrieren, um einen ganzheitlichen Schutz zu gewährleisten. Unterstützung für maschinenlesbare Formate: Die Bedrohungsdaten werden in Formaten wie STIX und TAXII bereitgestellt, was die automatische Verarbeitung und Integration erleichtert. Proaktive Bedrohungserkennung: Unternehmen können dank der umfassenden Bedrohungsinformationen proaktive Sicherheitsstrategien entwickeln und umsetzen. Vorteile für Ihr Unternehmen Frühzeitige Bedrohungserkennung: Die Echtzeit-Updates und umfassenden Informationen ermöglichen eine schnelle Identifizierung und Abwehr potenzieller Bedrohungen. Gezielte Abwehrmaßnahmen: Durch die detaillierte Bedrohungsanalyse können Unternehmen ihre Sicherheitsmaßnahmen gezielt anpassen und verbessern. Erhöhte Cybersicherheitsresilienz: Die proaktive Überwachung und Analyse von Open-Source-Bedrohungen erhöhen die Widerstandsfähigkeit gegenüber Cyberangriffen. Effiziente Ressourcenallokation: Die präzisen Bedrohungsdaten helfen Unternehmen, ihre Sicherheitsressourcen optimal einzusetzen und gezielte Maßnahmen zu ergreifen. Compliance und Risikomanagement: Die Lösung unterstützt Unternehmen bei der Einhaltung gesetzlicher Anforderungen und bei der effektiven Verwaltung von Cyberrisiken. Integration und Nutzung **Kaspersky Threat Data Feeds - Open Source Threats** kann problemlos in bestehende Sicherheitssysteme und -infrastrukturen integriert werden. Die Bedrohungsdaten werden in maschinenlesbaren Formaten wie STIX und TAXII bereitgestellt, sodass Unternehmen sie automatisch in ihre Systeme importieren und verarbeiten können. Diese Bedrohungsfeeds sind besonders hilfreich für Unternehmen, die ihre Cybersicherheitsstrategien kontinuierlich verbessern und ihre IT-Infrastruktur proaktiv schützen möchten. Anwendungsfälle für Kaspersky Threat Data Feeds - Open Source Threats Überwachung der Open-Source-Bedrohungslandschaft: Diese Lösung ist ideal für Unternehmen, die kontinuierlich über Bedrohungen aus Open-Source-Quellen informiert bleiben möchten. Frühzeitige Identifikation von Bedrohungen: Die Bedrohungsfeeds unterstützen die schnelle Erkennung und Abwehr potenzieller Cyberbedrohungen. Unterstützung bei der Entwicklung von Sicherheitsrichtlinien: Die bereitgestellten Informationen helfen bei der Erstellung gezielter Sicherheitsrichtlinien und der Stärkung der Cybersicherheitsmaßnahmen.31987,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Wie entsteht Big Data?
Big Data entsteht durch die Sammlung und Speicherung einer großen Menge von Daten aus verschiedenen Quellen wie Sensoren, Social Media, Transaktionen und mehr. Diese Daten werden dann mithilfe von speziellen Tools und Technologien analysiert und verarbeitet, um Muster, Trends und Erkenntnisse zu identifizieren. Durch die kontinuierliche Erfassung und Analyse von Daten in Echtzeit können Unternehmen fundierte Entscheidungen treffen und ihre Geschäftsprozesse optimieren. Letztendlich ermöglicht Big Data eine tiefere Einblicke in das Verhalten von Kunden, Trends auf dem Markt und ermöglicht die Entwicklung innovativer Produkte und Dienstleistungen. **
-
Was ist Big Data?
Big Data bezieht sich auf große Mengen an Daten, die mit hoher Geschwindigkeit und Vielfalt generiert werden. Diese Daten können aus verschiedenen Quellen stammen, wie zum Beispiel sozialen Medien, Sensoren oder Transaktionen. Big Data ermöglicht es Unternehmen, Muster und Trends zu identifizieren, um fundierte Entscheidungen zu treffen und ihre Geschäftsprozesse zu optimieren. **
-
Wie funktioniert Big Data Analytics?
Wie funktioniert Big Data Analytics? Big Data Analytics beinhaltet die Verarbeitung und Analyse großer Mengen von Daten, um Muster, Trends und Erkenntnisse zu identifizieren. Zunächst werden die Daten gesammelt und gespeichert, dann werden sie mithilfe von speziellen Tools und Algorithmen analysiert. Durch den Einsatz von Data Mining, maschinellem Lernen und künstlicher Intelligenz können Unternehmen wertvolle Einblicke gewinnen und fundierte Entscheidungen treffen. Die Ergebnisse der Analyse können für verschiedene Anwendungen genutzt werden, wie z.B. zur Verbesserung von Produkten und Dienstleistungen, zur Optimierung von Geschäftsprozessen oder zur Vorhersage von zukünftigen Entwicklungen. **
-
Was ist das Big Data?
Was ist das Big Data? Big Data bezieht sich auf die riesigen Mengen an Daten, die in unserer digitalen Welt generiert werden. Diese Daten stammen aus verschiedenen Quellen wie sozialen Medien, Sensoren, Mobilgeräten und mehr. Big Data zeichnet sich durch die 3Vs aus: Volumen, Vielfalt und Geschwindigkeit. Unternehmen nutzen Big Data, um Muster und Trends zu erkennen, fundierte Entscheidungen zu treffen und ihre Geschäftsprozesse zu optimieren. Es erfordert spezielle Tools und Technologien wie Data Mining, maschinelles Lernen und künstliche Intelligenz, um Big Data effektiv zu verarbeiten und zu analysieren. **

Ist Big Data eine Technologie?
Ist Big Data eine Technologie? Big Data ist eigentlich kein spezifisches Technologieprodukt, sondern vielmehr ein Konzept oder eine Herangehensweise, um große Mengen an Daten zu sammeln, zu speichern, zu analysieren und zu nutzen. Es umfasst verschiedene Technologien und Tools wie Datenbanken, Data Mining, maschinelles Lernen und künstliche Intelligenz, die verwendet werden, um Erkenntnisse aus den Daten zu gewinnen. Daher kann man sagen, dass Big Data eher eine Strategie oder ein Framework ist, das auf verschiedenen Technologien basiert, anstatt eine eigenständige Technologie zu sein. Letztendlich zielt Big Data darauf ab, Unternehmen dabei zu unterstützen, fundierte Entscheidungen auf der Grundlage von Daten zu treffen und Wettbewerbsvorteile zu erlangen. **
Wie wichtig ist Big Data?
Wie wichtig ist Big Data? Big Data spielt heutzutage eine entscheidende Rolle in nahezu allen Branchen, da Unternehmen immer mehr Daten sammeln und analysieren, um fundierte Entscheidungen zu treffen. Durch die Analyse großer Datenmengen können Unternehmen wertvolle Einblicke gewinnen, Trends erkennen und ihre Geschäftsstrategien optimieren. Zudem ermöglicht Big Data die Personalisierung von Produkten und Dienstleistungen, um die Bedürfnisse der Kunden besser zu verstehen und zu erfüllen. Insgesamt ist Big Data also von großer Bedeutung für den Erfolg und die Wettbewerbsfähigkeit von Unternehmen in der heutigen digitalen Welt. **
Top-Angebote
Produkte zum Begriff Mining-Big-Data-Integration:
-
Complete Guide to Open Source Big Data Stack, Fachbücher von Michael FramptonSehen Sie, wie ein auf Mesos basierender Big-Data-Stack erstellt wird und welche Komponenten verwendet werden. Sie werden derzeit verfügbare Apache-Systeme, sowohl vollständige als auch in der Inkubation befindliche, nutzen. Die Komponenten werden anhand von Beispielen vorgestellt, und Sie lernen, wie sie zusammenarbeiten. Im vollständigen Leitfaden zum Open-Source-Big-Data-Stack beginnt der Autor mit der Erstellung einer privaten Cloud und installiert und untersucht dann Apache Brooklyn. Anschliessend verwendet er jedes Kapitel, um ein Stück des Big-Data-Stacks vorzustellen, und teilt mit, wie man die Software beschafft und installiert. Sie lernen Schritt für Schritt und Kapitel für Kapitel anhand einfacher Beispiele, während ein echter Big-Data-Stack erstellt wird. Das Buch konzentriert sich auf Apache-basierte Systeme und bietet detaillierte Beispiele für Cloud-Speicher, Release-Management, Ressourcenmanagement, Verarbeitung, Warteschlangen, Frameworks, Datenvisualisierung und mehr. Was Sie lernen werden: - Installieren Sie eine private Cloud auf dem lokalen Cluster mit Apache Cloud Stack - Beschaffen, installieren und konfigurieren Sie Apache: Brooklyn, Mesos, Kafka und Zeppelin - Sehen Sie, wie Brooklyn verwendet werden kann, um Mule ESB in einem Cluster und Cassandra in der Cloud zu installieren - Installieren und verwenden Sie DCOS für die Big-Data-Verarbeitung - Verwenden Sie Apache Spark für die Datenverarbeitung im Big-Data-Stack Für wen dieses Buch gedacht ist: Entwickler, Architekten, IT-Projektmanager, Datenbankadministratoren und andere, die mit der Entwicklung oder Unterstützung eines Big-Data-Systems beauftragt sind. Es richtet sich auch an alle, die an Hadoop oder Big Data interessiert sind, sowie an diejenigen, die Probleme mit der Datengrösse haben.55,73 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Evolutionary Computation in Data Mining, Fachbücher von Ashish GhoshData Mining (DM) besteht darin, interessante Erkenntnisse aus realen, grossen und komplexen Datensätzen zu extrahieren und ist der zentrale Schritt eines umfassenderen Prozesses, der als Wissensentdeckung aus Datenbanken (KDD) bezeichnet wird. Neben dem DM-Schritt, der Wissen aus Daten extrahiert, umfasst der KDD-Prozess mehrere Vorverarbeitungs- (oder Datenvorbereitungs-) und Nachbearbeitungsschritte (oder Wissensverfeinerung). Das Ziel der Methoden zur Datenvorverarbeitung besteht darin, die Daten so zu transformieren, dass die Anwendung eines oder mehrerer gegebener DM-Algorithmen erleichtert wird, während das Ziel der Methoden zur Wissensverfeinerung darin besteht, entdecktes Wissen zu validieren und zu verfeinern. Idealerweise sollte das entdeckte Wissen nicht nur genau, sondern auch verständlich und interessant für den Benutzer sein. Der gesamte Prozess ist sehr rechenintensiv. Die Idee, Wissen automatisch aus Datenbanken zu entdecken, ist eine sehr attraktive und herausfordernde Aufgabe, sowohl für die Wissenschaft als auch für die Industrie. Daher gibt es ein wachsendes Interesse an Data Mining in mehreren KI-bezogenen Bereichen, einschliesslich evolutionärer Algorithmen (EAs). Die Hauptmotivation für die Anwendung von EAs auf KDD-Aufgaben besteht darin, dass sie robuste und adaptive Suchmethoden sind, die eine globale Suche im Raum der Kandidatenlösungen, wie Regeln oder andere Formen der Wissensdarstellung, durchführen.94,10 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Pattern Recognition and Data Mining, Fachbücher von Maneesha Singh, Chid Apte et alDas Fachbuch "Pattern Recognition and Data Mining" von Maneesha Singh und Chid Apte bietet eine umfassende Einführung in die Techniken und Methoden der Mustererkennung und des Data Minings. Mit einem klar strukturierten Ansatz werden grundlegende Konzepte sowie fortgeschrittene Techniken behandelt, die für Studierende und Fachleute im Bereich Technik und IT von Bedeutung sind. Das Buch umfasst 694 Seiten und ist in englischer Sprache verfasst. Es richtet sich an Leser, die ein vertieftes Verständnis für die Analyse von Daten und die Erkennung von Mustern entwickeln möchten. Die erste Auflage, veröffentlicht im Jahr 2005, bietet sowohl theoretische Grundlagen als auch praktische Anwendungen, die in der heutigen datengetriebenen Welt von grosser Relevanz sind. Die kompakte Grösse von 15,5 cm in der Breite und 23,5 cm in der Höhe macht das Buch zudem handlich und leicht transportierbar.94,10 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Data Integration in the Life Sciences, Fachbücher von Erhard RahmDas Fachbuch "Data Integration in the Life Sciences" von Erhard Rahm bietet eine umfassende Analyse der Techniken und Methoden zur Datenintegration in den Lebenswissenschaften. Es behandelt die Herausforderungen und Lösungen, die sich aus der Integration von Daten aus verschiedenen Quellen ergeben, und beleuchtet die Bedeutung dieser Prozesse für die Forschung und Entwicklung in den Lebenswissenschaften. Mit einem klaren Fokus auf Technik und IT bietet das Buch wertvolle Einblicke in die aktuellen Trends und Technologien, die zur Verbesserung der Datenverfügbarkeit und -nutzung beitragen. Die 226 Seiten umfassende Publikation ist in englischer Sprache verfasst und richtet sich an Fachleute, Studierende und Forschende, die sich mit der Datenintegration in ihrem Arbeitsfeld auseinandersetzen. Die erste Auflage, erschienen im Jahr 2004, bleibt ein relevantes Werk für alle, die die Komplexität der Datenintegration verstehen und anwenden möchten.49,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie beeinflusst künstliche Intelligenz den Bereich der Informatik? Welche Rolle spielen Big Data und Data Mining in der Informatik?
Künstliche Intelligenz optimiert Prozesse in der Informatik, automatisiert Aufgaben und ermöglicht neue Anwendungen wie maschinelles Lernen. Big Data und Data Mining sind wichtige Werkzeuge in der Informatik, um große Datenmengen zu analysieren, Muster zu erkennen und fundierte Entscheidungen zu treffen. Sie spielen eine zentrale Rolle bei der Entwicklung von KI-Systemen und der Optimierung von Algorithmen. **
-
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
-
Wie entsteht Big Data?
Big Data entsteht durch die Sammlung und Speicherung einer großen Menge von Daten aus verschiedenen Quellen wie Sensoren, Social Media, Transaktionen und mehr. Diese Daten werden dann mithilfe von speziellen Tools und Technologien analysiert und verarbeitet, um Muster, Trends und Erkenntnisse zu identifizieren. Durch die kontinuierliche Erfassung und Analyse von Daten in Echtzeit können Unternehmen fundierte Entscheidungen treffen und ihre Geschäftsprozesse optimieren. Letztendlich ermöglicht Big Data eine tiefere Einblicke in das Verhalten von Kunden, Trends auf dem Markt und ermöglicht die Entwicklung innovativer Produkte und Dienstleistungen. **
-
Was ist Big Data?
Big Data bezieht sich auf große Mengen an Daten, die mit hoher Geschwindigkeit und Vielfalt generiert werden. Diese Daten können aus verschiedenen Quellen stammen, wie zum Beispiel sozialen Medien, Sensoren oder Transaktionen. Big Data ermöglicht es Unternehmen, Muster und Trends zu identifizieren, um fundierte Entscheidungen zu treffen und ihre Geschäftsprozesse zu optimieren. **
Ähnliche Suchbegriffe für Mining-Big-Data-Integration
-
Kaspersky Threat Data Feeds - Open Source ThreatsKaspersky Threat Data Feeds – Open Source Threats In einer Zeit, in der Cyberbedrohungen komplexer und zielgerichteter denn je sind, ist eine umfassende Bedrohungsüberwachung unerlässlich. **Kaspersky Threat Data Feeds - Open Source Threats** stellt eine innovative Lösung dar, die Sicherheitsverantwortlichen aktuelle und relevante Informationen zu Bedrohungen bietet, die aus Open-Source-Quellen stammen. Diese Bedrohungsfeeds ermöglichen es Unternehmen, sich kontinuierlich über die neuesten Bedrohungen aus dem Open-Source-Bereich zu informieren und ihre Sicherheitsmaßnahmen entsprechend anzupassen. Mit Kaspersky Threat Data Feeds - Open Source Threats können Unternehmen proaktiv auf Bedrohungen reagieren und so ihre Widerstandsfähigkeit gegenüber Cyberangriffen deutlich verbessern. Überblick über Kaspersky Threat Data Feeds - Open Source Threats Die Lösung **Kaspersky Threat Data Feeds - Open Source Threats** bietet Unternehmen Zugang zu einer Fülle an Bedrohungsdaten, die speziell aus Open-Source-Quellen gesammelt werden. Diese Feeds bieten detaillierte Informationen über aktuelle Bedrohungen und ermöglichen eine proaktive Abwehr. Durch die kontinuierliche Analyse und Filterung relevanter Daten aus öffentlich zugänglichen Quellen hilft Kaspersky Unternehmen dabei, potenzielle Gefahren frühzeitig zu erkennen und geeignete Schutzmaßnahmen zu implementieren. Hauptfunktionen Echtzeit-Updates zu Open-Source-Bedrohungen: Regelmäßige Aktualisierungen, die es Unternehmen ermöglichen, stets über die neuesten Bedrohungen informiert zu sein. Umfassende Bedrohungsanalyse: Detaillierte Informationen zu Bedrohungen, die aus Open-Source-Quellen stammen und für die Cybersicherheit von Bedeutung sind. Integration in bestehende Sicherheitslösungen: Kaspersky Threat Data Feeds lassen sich problemlos in vorhandene Sicherheitssysteme integrieren, um einen ganzheitlichen Schutz zu gewährleisten. Unterstützung für maschinenlesbare Formate: Die Bedrohungsdaten werden in Formaten wie STIX und TAXII bereitgestellt, was die automatische Verarbeitung und Integration erleichtert. Proaktive Bedrohungserkennung: Unternehmen können dank der umfassenden Bedrohungsinformationen proaktive Sicherheitsstrategien entwickeln und umsetzen. Vorteile für Ihr Unternehmen Frühzeitige Bedrohungserkennung: Die Echtzeit-Updates und umfassenden Informationen ermöglichen eine schnelle Identifizierung und Abwehr potenzieller Bedrohungen. Gezielte Abwehrmaßnahmen: Durch die detaillierte Bedrohungsanalyse können Unternehmen ihre Sicherheitsmaßnahmen gezielt anpassen und verbessern. Erhöhte Cybersicherheitsresilienz: Die proaktive Überwachung und Analyse von Open-Source-Bedrohungen erhöhen die Widerstandsfähigkeit gegenüber Cyberangriffen. Effiziente Ressourcenallokation: Die präzisen Bedrohungsdaten helfen Unternehmen, ihre Sicherheitsressourcen optimal einzusetzen und gezielte Maßnahmen zu ergreifen. Compliance und Risikomanagement: Die Lösung unterstützt Unternehmen bei der Einhaltung gesetzlicher Anforderungen und bei der effektiven Verwaltung von Cyberrisiken. Integration und Nutzung **Kaspersky Threat Data Feeds - Open Source Threats** kann problemlos in bestehende Sicherheitssysteme und -infrastrukturen integriert werden. Die Bedrohungsdaten werden in maschinenlesbaren Formaten wie STIX und TAXII bereitgestellt, sodass Unternehmen sie automatisch in ihre Systeme importieren und verarbeiten können. Diese Bedrohungsfeeds sind besonders hilfreich für Unternehmen, die ihre Cybersicherheitsstrategien kontinuierlich verbessern und ihre IT-Infrastruktur proaktiv schützen möchten. Anwendungsfälle für Kaspersky Threat Data Feeds - Open Source Threats Überwachung der Open-Source-Bedrohungslandschaft: Diese Lösung ist ideal für Unternehmen, die kontinuierlich über Bedrohungen aus Open-Source-Quellen informiert bleiben möchten. Frühzeitige Identifikation von Bedrohungen: Die Bedrohungsfeeds unterstützen die schnelle Erkennung und Abwehr potenzieller Cyberbedrohungen. Unterstützung bei der Entwicklung von Sicherheitsrichtlinien: Die bereitgestellten Informationen helfen bei der Erstellung gezielter Sicherheitsrichtlinien und der Stärkung der Cybersicherheitsmaßnahmen.31987,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
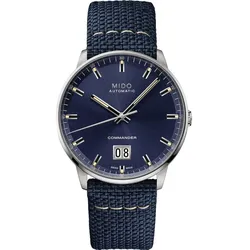
Mido Commander Big Data Herrenuhr M021.626.17.041.00Die Commander Big Date M021.626.17.041.00 von MIDO feiert das 100-jährige Jubiläum der Marke. Ihr großes Datumsfenster bei 6 Uhr bietet unübertroffene Ablesbarkeit. Das satinierte Sonnenschliff-Zifferblatt in Blau, eingefasst in ein elegantes, rundes Gehäuse aus satiniertem Edelstahl und veredelt durch eine polierte Lünette, strahlt schlichte Eleganz aus. Ausgestattet mit dem Kaliber 80, einem automatischen Uhrwerk, bietet diese Uhr eine Gangreserve von bis zu 80 Stunden. Ein transparenter Gehäuseboden und ein Textilarmband mit Kalbsleder und synthetischem Futter runden das Design ab. Großes Datumsfenster bei 6 Uhr Satinierte Sonnenschliff-Zifferblatt in Blau Automatikwerk Mido ETA Kaliber 80 Gangreserve bis zu 80 Stunden Edelstahlgehäuse mit polierter Lünette Wasserdicht bis 5 bar (50 m / 165 ft) Saphirglas Transparenter Gehäuseboden Textilarmband mit Kalbsleder und synthetisch...1020,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Cleve, Jürgen: Data MiningData Mining , Datenanalyse für Künstliche Intelligenz , Luft- & Hydraulikfederung > Sportfederung , Auflage: 4. Auflage, Erscheinungsjahr: 20240506, Produktform: Kartoniert, Titel der Reihe: De Gruyter Studium##, Autoren: Cleve, Jürgen~Lämmel, Uwe, Auflage: 24004, Auflage/Ausgabe: 4. Auflage, Abbildungen: 176 b/w illustrations, 54 b/w tbl., Themenüberschrift: COMPUTERS / Data Processing, Keyword: Artificial Intelligence; Big Data; Data Mining; Machine Learning, Fachschema: Analyse / Datenanalyse~Datenanalyse~EDV / Theorie / Allgemeines~Data Mining (EDV)~Informatik~Intelligenz / Künstliche Intelligenz~KI~Künstliche Intelligenz - AI, Fachkategorie: Informationstechnik (IT), allgemeine Themen~Datenerfassung und -analyse~Data Mining~Praktische Anwendung für Informationstechnologien~Künstliche Intelligenz, Warengruppe: HC/Informatik, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 238, Breite: 167, Höhe: 21, Gewicht: 580, Produktform: Kartoniert, Genre: Mathematik/Naturwissenschaften/Technik/Medizin,79,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie funktioniert Big Data Analytics?
Wie funktioniert Big Data Analytics? Big Data Analytics beinhaltet die Verarbeitung und Analyse großer Mengen von Daten, um Muster, Trends und Erkenntnisse zu identifizieren. Zunächst werden die Daten gesammelt und gespeichert, dann werden sie mithilfe von speziellen Tools und Algorithmen analysiert. Durch den Einsatz von Data Mining, maschinellem Lernen und künstlicher Intelligenz können Unternehmen wertvolle Einblicke gewinnen und fundierte Entscheidungen treffen. Die Ergebnisse der Analyse können für verschiedene Anwendungen genutzt werden, wie z.B. zur Verbesserung von Produkten und Dienstleistungen, zur Optimierung von Geschäftsprozessen oder zur Vorhersage von zukünftigen Entwicklungen. **
-
Was ist das Big Data?
Was ist das Big Data? Big Data bezieht sich auf die riesigen Mengen an Daten, die in unserer digitalen Welt generiert werden. Diese Daten stammen aus verschiedenen Quellen wie sozialen Medien, Sensoren, Mobilgeräten und mehr. Big Data zeichnet sich durch die 3Vs aus: Volumen, Vielfalt und Geschwindigkeit. Unternehmen nutzen Big Data, um Muster und Trends zu erkennen, fundierte Entscheidungen zu treffen und ihre Geschäftsprozesse zu optimieren. Es erfordert spezielle Tools und Technologien wie Data Mining, maschinelles Lernen und künstliche Intelligenz, um Big Data effektiv zu verarbeiten und zu analysieren. **
-
Ist Big Data eine Technologie?
Ist Big Data eine Technologie? Big Data ist eigentlich kein spezifisches Technologieprodukt, sondern vielmehr ein Konzept oder eine Herangehensweise, um große Mengen an Daten zu sammeln, zu speichern, zu analysieren und zu nutzen. Es umfasst verschiedene Technologien und Tools wie Datenbanken, Data Mining, maschinelles Lernen und künstliche Intelligenz, die verwendet werden, um Erkenntnisse aus den Daten zu gewinnen. Daher kann man sagen, dass Big Data eher eine Strategie oder ein Framework ist, das auf verschiedenen Technologien basiert, anstatt eine eigenständige Technologie zu sein. Letztendlich zielt Big Data darauf ab, Unternehmen dabei zu unterstützen, fundierte Entscheidungen auf der Grundlage von Daten zu treffen und Wettbewerbsvorteile zu erlangen. **
-
Wie wichtig ist Big Data?
Wie wichtig ist Big Data? Big Data spielt heutzutage eine entscheidende Rolle in nahezu allen Branchen, da Unternehmen immer mehr Daten sammeln und analysieren, um fundierte Entscheidungen zu treffen. Durch die Analyse großer Datenmengen können Unternehmen wertvolle Einblicke gewinnen, Trends erkennen und ihre Geschäftsstrategien optimieren. Zudem ermöglicht Big Data die Personalisierung von Produkten und Dienstleistungen, um die Bedürfnisse der Kunden besser zu verstehen und zu erfüllen. Insgesamt ist Big Data also von großer Bedeutung für den Erfolg und die Wettbewerbsfähigkeit von Unternehmen in der heutigen digitalen Welt. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.